Self-Attentionの概要
1. Self-Attentionの概要
Self-Attentionは、各トークンが他のすべてのトークンとの依存関係や文脈情報を計算する仕組みです。たとえば、文「I am a student」の場合、4つのトークン("I", "am", "a", "student")それぞれが、他のトークンとどれだけ関連しているかを同時に評価します。
このプロセスでは、以下の3つのベクトルが重要な役割を果たします: - Query (Q): 他のトークンとの関連性を「尋ねる」ベクトル。 - Key (K): 他のトークンとの関連性を「示す」ベクトル。 - Value (V): 実際に情報として使われるベクトル。
これらを用いて、トークン間の関連性を計算し、文脈を考慮した新しいトークン表現を生成します。
2. 入力と埋め込み
Self-Attentionの計算は、まず入力シーケンスをベクトル形式に変換するところから始まります。 - 入力: 文「I am a student」を例にすると、4つのトークンがあります。 - 埋め込み: 各トークンは、事前学習された埋め込みベクトル(例えばWord2VecやGloVe)によって数値化されます。これにより、文は以下のようなベクトルの行列として表現されます: [ X = [x_1, x_2, x_3, x_4] ] ここで、( x_1 ) は "I" の埋め込みベクトル、( x_2 ) は "am" の埋め込みベクトル、といった具合です。
3. Query, Key, Valueの生成
Self-Attentionでは、各トークンの埋め込みベクトル ( x_i ) に対して、3つのベクトル(Query, Key, Value)を生成します。これには、学習済みの重み行列 ( W_q )、( W_k )、( W_v ) が使用されます。計算は次のように行われます: [ Q = X W_q, \quad K = X W_k, \quad V = X W_v ] - ( X ): 入力トークンの埋め込みベクトルの行列。 - ( W_q, W_k, W_v ): モデルが学習する重み行列で、それぞれQuery、Key、Valueを生成します。 - 結果として、各トークン ( i ) に対して ( q_i )、( k_i )、( v_i ) が得られます。
たとえば、トークン "I" に対して: - ( q_1 = x_1 W_q )("I" のQueryベクトル) - ( k_1 = x_1 W_k )("I" のKeyベクトル) - ( v_1 = x_1 W_v )("I" のValueベクトル)
このステップでは、すべてのトークンに対して同じ重み行列が適用されるため、計算は一貫性を持ちます。
4. Attentionスコアの計算
次に、各トークンが他のトークンとどれだけ関連しているかを計算します。これを「Attentionスコア」と呼びます。
具体的には、トークン ( i ) のQuery ( q_i ) と、すべてのトークン ( j ) のKey ( k_j ) との内積を計算します: [ \text{score}_{i,j} = q_i \cdot k_j ] - この内積は、トークン ( i ) と ( j ) の関連性の強さを表します。値が大きいほど、関連性が高いとみなされます。
しかし、内積の値が大きくなりすぎると後の計算で問題が生じるため、スケーリングを行います: [ \text{scaled_score}_{i,j} = \frac{q_i \cdot k_j}{\sqrt{d_k}} ] - ( d_k ): Keyベクトルの次元。 - スケーリングは、値が大きくなりすぎるのを防ぎ、勾配消失問題を回避するために重要です。
たとえば、"I" と "am" の関連性を計算する場合: - ( q_1 \cdot k_2 ) を計算し、( \sqrt{d_k} ) で割ります。
5. Softmaxによる正規化
Attentionスコアを正規化して、トークン間の関連性を確率分布として表現します。これにはSoftmax関数を使います: [ \alpha{i,j} = \text{softmax}(\text{scaled_score}{i,j}) = \frac{\exp(\text{scaled_score}{i,j})}{\sum{k} \exp(\text{scaled_score}{i,k})} ] - ( \alpha{i,j} ): トークン ( i ) がトークン ( j ) にどれだけ注意を払うかを示す重み。 - ( \sum{j} \alpha{i,j} = 1 ) となるため、各トークンに対する注意の合計が1に正規化されます。
たとえば、"I" に対して "am", "a", "student" のスコアを正規化し、それぞれの重みを得ます。
6. Valueの重み付き和
最後に、正規化された重み ( \alpha{i,j} ) を使って、Valueベクトル ( v_j ) の重み付き和を計算します: [ z_i = \sum{j} \alpha_{i,j} v_j ] - ( z_i ): トークン ( i ) のSelf-Attentionの出力。 - この出力は、トークン ( i ) が他のトークンから受け取った文脈情報を反映した新しい表現です。
たとえば、"I" の出力 ( z_1 ) は: - "am", "a", "student" の ( v_j ) を ( \alpha_{1,j} ) で重み付けして足し合わせたもの。
これにより、"I" は文脈("am a student")を考慮した表現に更新されます。
7. 並列計算の利点
Self-Attentionの大きな特徴は、すべてのトークン間の依存関係を並列に計算できる点です。 - たとえば、文「I am a student」では、4つのトークンそれぞれが他のトークンとの関連性を同時に計算します。 - 行列演算を用いることで、以下のように一度に計算可能です: [ \text{Self-Attention Output} = \text{softmax}\left( \frac{Q KT}{\sqrt{d_k}} \right) V ] - これにより、シーケンスの長さに依存せず、高速かつ効率的に処理できます。 - 対照的に、RNNやLSTMではトークンを順次処理するため、計算時間がシーケンスの長さに比例して増大します。
まとめ
Self-Attentionの仕組みをまとめると以下の通りです: 1. 各トークンの埋め込みベクトルから、学習済みの重み行列 ( W_q )、( W_k )、( W ( W_v ) を使ってQuery (Q)、Key (K)、Value (V) を生成。 2. QとKの内積を計算し、スケーリング(( \sqrt{d_k} ) で割る)してAttentionスコアを得る。 3. スコアをSoftmaxで正規化し、トークン間の関連性の重み(( \alpha ))を計算。 4. 重みを使ってVの重み付き和を計算し、文脈を考慮した新しいトークン表現を生成。 5. すべての計算を並列で行うことで、効率的に依存関係を捉える。
このメカニズムにより、Transformerモデルは長いシーケンスでも文脈情報を効果的に扱え、自然言語処理タスクで高い性能を発揮します。
transformer
エンコーダーの流れの確認
提供されたエンコーダーのプロセスは、Transformerの標準的なアーキテクチャを正確に反映しています。以下に各ステップを簡潔に確認します:
位置エンコーディング
Self-Attention(自己注意)
Scaled Dot-Product Attention
- アテンションスコアを ( QKT / \sqrt{d_k} ) で計算し、softmax関数で正規化後、重みづけ加重和を求めます。
- ( \sqrt{d_k} ) でスケーリングすることで勾配消失を防ぎ、Multi-Head Attentionで複数の視点からの情報を取得。
- 各ヘッドの出力を連結し、線形変換して次の層へ渡します。
残差接続 + Layer Normalization
- Self-Attentionの出力に元の入力を加算(残差接続)し、Layer Normalizationを適用。
- 学習の安定性向上と勾配消失問題の緩和に寄与します。
Feed Forward Network (FFN)
- 各トークンに独立に適用される2層の全結合層(通常ReLU活性化を使用)。
- このプロセスをN層繰り返します。
出力
この流れは、Transformerエンコーダーの動作を正確に記述しており、問題ありません。
デコーダーの流れの確認
デコーダーのプロセスも標準的なTransformerの自己回帰的生成プロセスを正確に表しています。以下に確認します:
位置エンコーディング + 埋め込み
Masked Multi-Head Self Attention
- 未来のトークンを見ないようにマスクを適用。これにより、生成の順序性(左から右)が保証されます。
- Self-Attentionを複数のヘッドに分割し、異なる視点からの情報を並列に計算して結合。
Encoder-Decoder Attention
残差接続 + Layer Normalization
- エンコーダー同様、残差接続とLayer Normalizationで安定化。
Feed Forward Network (FFN)
- N層繰り返し適用され、最終出力ベクトルが生成されます。
Linear + Softmax
- 出力ベクトルを線形変換し、softmaxで語彙全体の確率分布に変換。
- 最も確率の高いトークンを選択し、次の入力として使用(逐次生成)。
Masked Multi-Head Self Attentionのマスク化について
学習時
推論時
したがって、Masked Multi-Head Self Attentionのマスク化は主に学習時に重要な役割を果たし、推論時には直接的には関係ない。
Databricks機能
| カテゴリ | 機能 | 説明とサブ機能 |
|---|---|---|
| データ管理 | Delta Lake | ACIDトランザクション、スキーマ強制、タイムトラベルを備えた信頼性の高いデータレイク。 |
| Unity Catalog | データおよびAIアセットの集中管理とガバナンス。アクセス制御や監査ログを含む。 | |
| Data Explorer | データアセットの探索および管理のためのユーザーインターフェース。 | |
| Delta Sharing | データの複製なしに組織間でライブデータを安全に共有。 | |
| Data Lineage | プラットフォーム全体でのデータ起源と依存関係の追跡。 | |
| コンピュート管理 | Clusters | Databricks Runtimeで動作するコンピュートリソース。
|
| Jobs | クラスタ上でタスクをスケジュールおよびオーケストレーションする自動化ワークフロー。 | |
| ワークスペース | Notebooks | データ探索、分析、可視化のためのインタラクティブなコーディング環境。 |
| Libraries | ノートブックやジョブで使用するパッケージのインストールと管理。 | |
| Repos | ノートブックやその他のファイルのバージョン管理(Gitと統合)。 | |
| アナリティクス | Databricks SQL | データレイク上でSQLクエリを実行し分析・可視化するサービス。以下を含む: |
| SQL Search | Databricks SQL内でSQLを使用してデータを検索・分析する機能。 | |
| 機械学習とAI | Mosaic AI | AIおよび機械学習のための製品群。以下を含む: |
Googleの本気AI「Gemini」は、手書きの領収書のOCRとして使えるのか
はじめに
Google日本法人は2023年12月7日、最新AIモデル「Gemini」を発表しました。
テキスト、画像、音声、動画、コードなど複数の情報形式を扱えるマルチモーダルを実現するために1から設計したとのことです。
Geminiを試すには
現時点だと英語版Google Bardで試すことが可能です。
日本に居ても、下記設定ページで言語を「English」に設定、オプションを選択で「United States」を選択することで利用可能なようです。
Experiment updatesに下記が表示されたので問題なさそうです。
2023.12.06
Bard is getting its biggest upgrade yet with Gemini Pro
- What: Starting today, we’re introducing Gemini Pro in Bard, for Bard’s biggest upgrade yet. We’ve specifically tuned Gemini Pro in Bard to be far more capable at things like understanding and summarizing, reasoning, coding, and planning. You can try out Bard with Gemini Pro for text-based prompts, with support for other modalities coming soon. It will be available in English in more than 170 countries and territories to start, and come to more languages and places, like Europe, in the near future.
- Why: Today, Google introduced Gemini, the most capable AI model in the world. Gemini unlocks new ways to create, interact and collaborate with Bard.
実際にOCRを試してみた
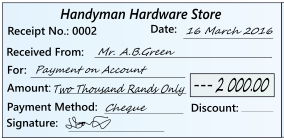
サンプルの手書きの領収書を使ってOCR機能を試してみました。
Q:
Read the contents of the receipt and create a list of items and contents.
A:
The receipt is from Handyman Hardware Store and shows that Mr. A.B. Green purchased the following items on March 16, 2016:
- Hammer
- Saw
- Drill
- Hammerhead
- Saw
- Drill
- Saw
The total amount of the purchase was 2000 Rands.
The image also shows that the receipt was generated using TurboCASH5 software.
感想
OCRは手書きも対応できてますね、お店の名前からハンマーやドリルなど明細項目をクリエイトしてくれています。領収書作成のソフトウェアを答えているのがおもしろいです。
LLMはマルチモーダルの時代に突入ですね、色々と苦しくなる会社が出てきそうです。
それでは。
領収書サンプル:TurboCASH5 - USA - Online Help
強化学習とは
強化学習とは
強化学習とは、機械学習の一つで、エージェントが環境とやり取りしながら報酬を最大化するための適切な行動を学習する仕組みです。
最終的な価値を最大化するためのエージェントの行動を予測し続けます。
自動運転自動車の例を交えながら、全体像を捉えるために、強化学習の基本的な概念と学習プロセスを簡単に説明します。
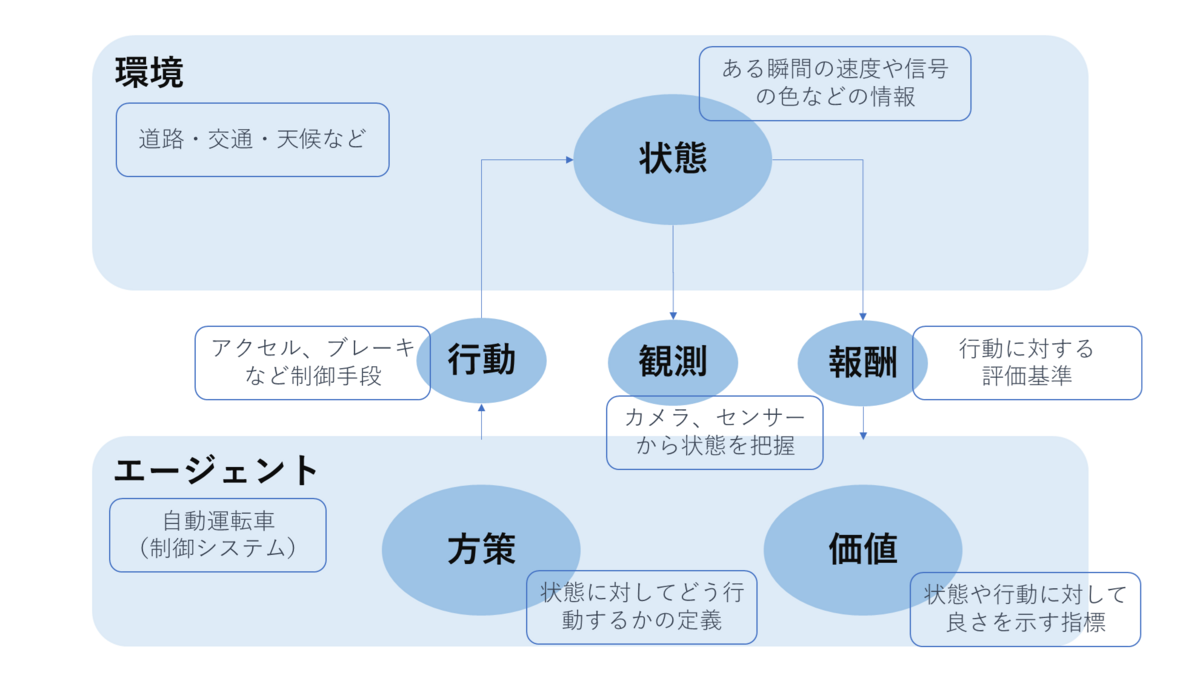
強化学習の基本要素
エージェント(Agent)
自動運転車(自動運転制御システム)がエージェントとなります。 エージェントは環境と相互作用し、状態の観測と行動の選択を通じて目標を達成しようとします。
環境(Environment)
道路、交通、天候など自動運転車が走行する要素全般が環境を構成します。
状態(State)
エージェントのその瞬間における速度や信号の色などの状況。報酬に影響を与える要因や情報の集合となります。
観測(Observation)
カメラ、センサーから得られた情報を通じて状態を把握します。
行動(Action)
アクセル、ブレーキ、ハンドルのような制御の手段。エージェントはこれらの行動を選択し、環境に影響を与えます。
報酬(Reward)
エージェントが選択した行動に対する即時の評価基準。安全な運転やスムーズな走行などで報酬を得るよう報酬関数を作成します。
学習プロセス
価値(Value)
エージェントが状態や行動に対して、最終的にどれだけ良いか(累積報酬の期待値)を示す指標のことです。
エージェントは次の状態と即時報酬のフィードバックをもとに、状態価値関数や行動価値関数を学習します。
学習のための代表的なアルゴリズムとして、状態価値関数にはモンテカルロ法、行動価値関数にはQ学習 (Q-Learning) などがあります。Q学習では、状態と行動の組み合わせに対する価値(Q値)を学習します。
方策(Policy)
エージェントが特定の状態においてどのような行動を選択するかを定義する戦略やルールの集合のことです。
エージェントは価値関数が最大となるように方策関数を学習します。
ある状態において常に同じ行動を選択する確定的方策(赤信号は停止する など)とある状態において複数の行動を確率的に選択する確率的方策があります。
代表的なアルゴリズムとして、確率的方策では方策勾配法(Policy Gradient Methods)などがあります。確定的方策では通常、深層学習ベースの手法が利用されます。
推論プロセス
学習済みの価値関数が推論時に使用されます。状態に対して最も高い価値を持つ行動が選択され、エージェントは最適な行動を実行します。
学習済みの方策関数が推論時に使用されます。状態に応じて確率的に行動が選択され、エージェントは柔軟に対応できます。
まとめ
強化学習では、エージェントが環境との相互作用を通じて観測する状態や即時報酬から価値関数や方策関数を学習します。推論時は随時、状態から価値(累積報酬の期待値)が最大となる行動を選択し実行し続けます。
Azure OpenAI Service ChatGPT のファインチューニングについて
- はじめに
- ファインチューニング(微調整)とは
- ファインチューニング以外のアプローチ(転移学習とフューショット学習(Few-shot Learning))
- Azure OpenAI Serviceのモデル微調整について
はじめに
ChatGPTの活用を検討する中で、よく耳にするキーワードが「ファインチューニング」です。 この記事では、その詳細と具体的な使われ方を解説します。
ファインチューニング(微調整)とは
ファインチューニングは、事前学習モデルに対して、新たなデータで追加学習を行い、モデルのパラメータ(重み)を微調整する手法です。
具体的には、学習済みモデルに対して、層の追加、一部またはすべての層を再訓練しパラメータを永続的に変更します。
特定のドメインやタスクにおいて、モデルの最適化やプロンプトの効率化を目指す場合、ファインチューニングの適用を検討します。
ただし、多数のパラメータに対して適切に調整を行うには、大量の学習データが必要となります。

ファインチューニング以外のアプローチ(転移学習とフューショット学習(Few-shot Learning))
転移学習とは
転移学習は、ファインチューニングとプロセスが似ていますが、既存層のパラメータは変更せず(フリーズ)、追加した出力層のパラメータのみを変更する点が異なります。学習データ量が多くない場合の選択肢となります。
フューショット学習とは
フューショット学習は、ファインチューニングとプロセスが異なります。学習済モデルに対する再訓練(パラメータ変更)は行いません。
一般的な特徴空間上での関連性やパターンを利用して、メタ学習などのアプローチにより、少量のデータで新しいタスクを学習させる手法です。
非常に少ないデータで対応することが可能です。
OpenAIから発表された論文「Language Models are Few-Shot Learners」では、GPT-3でZero/One/Few-shot learningを行ったシナリオ試験の結果が記載されており、パラメータの変更は行わず、多くのデモンストレーションを与えることで、多様なタスクを遂行できることが示されています。
Azure OpenAI Serviceのモデル微調整について
公式マニュアル「微調整によってモデルをカスタマイズする」 learn.microsoft.com
2023/10/29現在、gpt-35-turbo-0613の場合、データセットの形式は下記のようなJSON形式となってます。データセットを用意してモデル微調整する機能が提供されています。
{"messages": [{"role": "system", "content": "あなたは織田信長です"}, {"role": "user", "content": "友達は?"}, {"role": "assistant", "content": "家康は幼馴染で信頼関係のある仲じゃ"}]}
{"messages": [{"role": "system", "content": "あなたは織田信長です"}, {"role": "user", "content": "最大のライバルは?"}, {"role": "assistant", "content": "やはり、甲斐の武田信玄じゃろう"}]}
{"messages": [{"role": "system", "content": "あなたは織田信長です"}, {"role": "user", "content": "好物は?"}, {"role": "assistant", "content": "実はうなぎが大好きじゃ"}]}
・・・
DALL-E3で作った女性画像に対して、HeyGenを使って声と動作を吹き込みました
はじめに
以前、DALL-E3で女性のポートレートを作成し、下記記事で紹介しました。
今回は、その画像を使い、HeyGenを使って音声と動作を吹き込みました。
利用した写真

HeyGenを利用
HeyGenに人物画像を取り込み、セリフをテキスト入力して、声の種類を選択しただけというシンプルな設定を行いました。
2回まで無料で試すことができます。

結果
Submitを押すと、表情と音声が吹き込まれた動画が作成されました。